PDF / 画像OCR
PDFや画像から文字を読み取り、テキストとして扱える形にします。
読める文字で
PDFや画像から文字を読み取り、書類の種類に応じて金額や日付などの項目を取り出して、ExcelやCSVなど次の作業で使える形にするアプリです。

書類をOCRしても、誤認識の確認と、必要な項目の取り出しが別作業として残ります。APOUL OCR Readerは、文字認識だけで終わらせず、金額や日付といった項目や表の構造まで取り出して、ExcelやCSVなど次の作業で使える形にすることを重視しています。
開発中の Mac の画面です。書類は架空の見本で、公開時に変わることがあります。
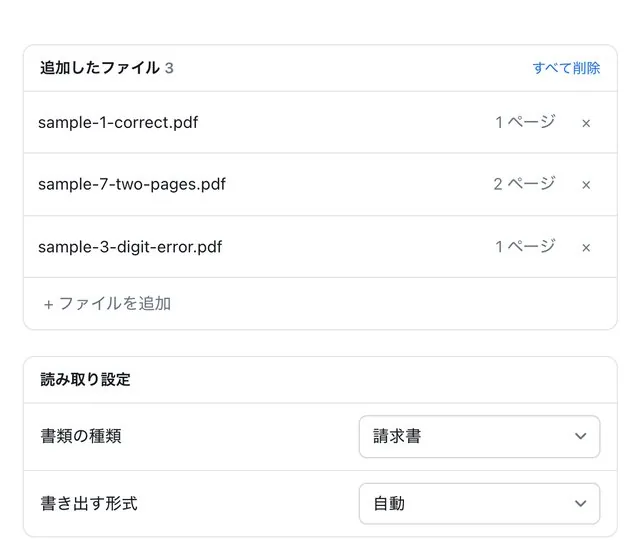
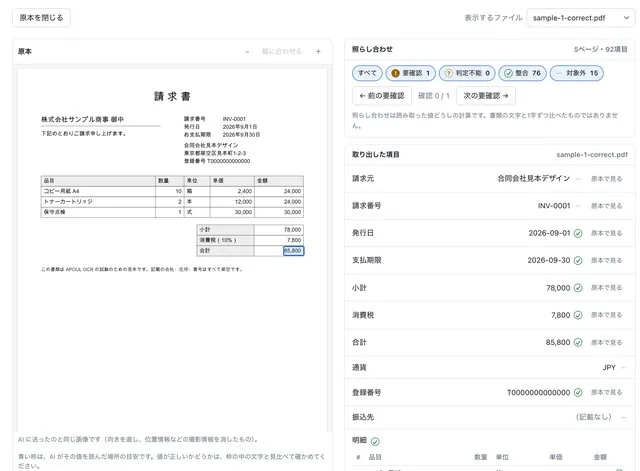
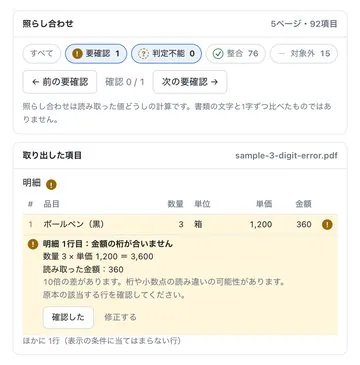
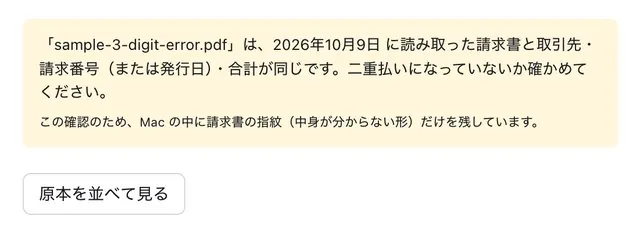
読み取った文字を、どう使える情報に変えるかを紹介します。
PDFや画像から文字を読み取り、テキストとして扱える形にします。
領収書・請求書・伝票から、金額や日付、取引先などの項目を取り出します。
読み取った複数の書類を、1件1行にまとめたExcelの一覧にします。金額は数値、日付は日付として入るので、そのまま計算や並べ替えができます。
書類の種類にかかわらず、表の構造をExcelのセルとして取り出します。
帳票以外の一般文書では、題名・見出し・要約を返します。
取り出した項目(請求元・日付・金額など)は、アプリの中で確かめて直せます。直した値は書き出すファイルに使われ、元の値も確認の記録として残ります。読み取った全文(書き写し)はアプリの中では直せないため、書き出したファイルで直してください。
書類の種類は自動で判定でき、手動でも選べます。
画面は日本語と英語を切り替えられます。
機能名ではなく、使った先に何が楽になるかで整理しています。
スキャン書類や画像内の文字をテキスト化。
領収書や請求書の金額・日付・取引先を取り出して、1件1行の一覧にする。
罫線のある表を、セルの結合ごとExcelの表として取り出す。
帳票以外の文書から、題名・見出し・要約を取り出して概要をつかむ。
説明書を読み込まなくても、次の操作が分かることを優先します。
PDFまたは画像をOCR。
保存する前に、読み取り結果を画面で確認。
Excel / CSV / JSON / テキストへ書き出し、次の作業へ。
APOUL OCR Readerは、書類の読み取りをクラウドで行います。読み取りのために、選択した書類は暗号化された通信でAPOULのサーバへ送信され、外部のAIサービスで処理されます。
処理が終わった書類の内容をAPOULは保存しません。サーバに残るのは、処理したページ数・日時・消費クレジットといった利用記録のみです。Excelやテキストなど、出力ファイルの作成はお使いの端末で行います。
書類を外部に送信したくない場合は、本製品をご利用いただけません。
OCRやAI抽出の結果には、誤りが含まれることがあります。保存する前に画面でご確認いただけます。文書の種類によっては、法的・業務的な最終判断を人が行うことを前提にします。
この製品が扱う困りごとや、導入の前に整理しておくことを書いています。